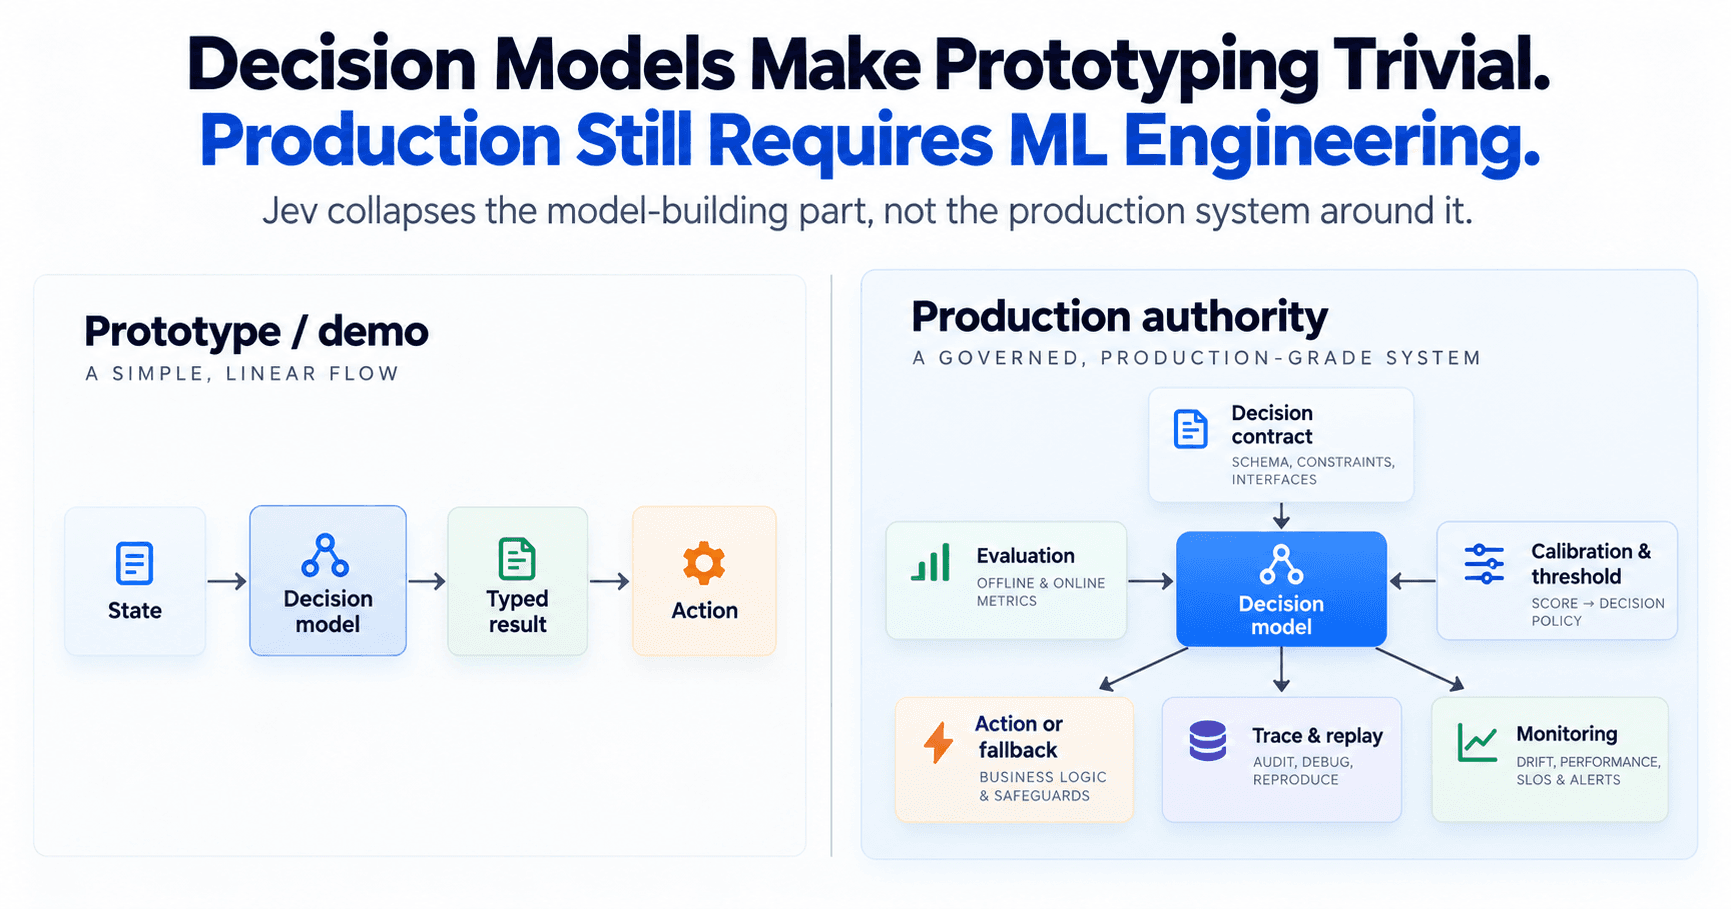
재사용 가능한 결정 모델(Decision Model)이 특정 작업에 대한 모델 학습(training)을 생략하여 초기 프로토타입 개발을 매우 쉽게 만들 수 있지만, 실제 서비스 환경(프로덕션)에서 안정적으로 운영하기 위한 ML 엔지니어링 작업은 여전히 필수적이라는 분석이 나왔습니다. 이는 모델 개발의 병목을 줄여주지만, 결정 모델이 비즈니스 프로세스에 대한 권한을 갖게 되는 순간부터는 모델 자체의 품질을 넘어선 광범위한 검증과 관리가 필요하다는 의미입니다.
결정 모델은 주어진 상태에서 경계가 명확한 질문에 대한 확률이나 점수를 제공하여 특정 행동으로 연결하는 방식으로 작동합니다. 이는 기존의 분류기(classifier) 학습, 별도의 서빙 스택, 미세조정(fine-tuning) 과정 없이도 빠르게 프로토타입을 만들 수 있게 합니다. 예를 들어, 고객 지원 AI 에이전트가 '상담사를 연결해야 하는가?', '어떤 도구를 사용해야 하는가?'와 같은 다섯 가지 결정을 내릴 때, 각 분기는 '상태 → 경계 질문 → 확률 → 행동'과 같은 간단한 구조로 구현될 수 있습니다. 이를 통해 엔지니어는 하루에도 여러 결정을 추가하여 설득력 있는 데모를 만들 수 있습니다. 그러나 이러한 편리함은 '일단 배포하고 나중에 검증하자'는 위험한 유혹으로 이어질 수 있습니다.
모델이 '95% 정확하다', '학습이 필요 없다'는 주장은 모델 자체의 성능에 대한 것이지만, 실제 운영 환경에서는 해당 모델이 특정 트래픽 분포에서 얼마나 정확하게 작동하는지, 오류 발생 시 비용은 얼마인지, 어떤 예외 상황이 발생할 수 있는지 등 훨씬 더 복잡한 증거가 필요합니다. 즉, 모델 구축이 아무리 저렴해져서 수백 개의 작은 의미론적 결정들이 자동화 후보가 된다 해도, 실제 시스템이 신뢰할 만한 증거를 축적하기 전까지는 생산 준비가 완료되었다고 볼 수 없습니다. 결국, 결정 모델은 개별 결정에 대한 모델 학습은 제거할 수 있지만, 개별 결정에 대한 검증 작업은 사라지지 않고 다른 형태로 전환될 뿐입니다. 이는 비즈니스 정의, 증거 구성, 대표적인 평가 데이터셋 구축, 위험 및 커버리지 분석, 임계값 설정, 모니터링, 그리고 변경 관리 등 광범위한 ML 엔지니어링 작업이 여전히 중요하다는 것을 시사합니다. 모델의 정확성뿐만 아니라, 실제 비즈니스 목표와 운영 환경에 맞는 포괄적인 검증 체계를 갖추는 것이 성공적인 AI 시스템 구축의 핵심입니다.