yozm.tech
피드로 돌아가기
Hacker News (Top)HOTAI 재작성

맥북 에어에서 1시간 음성 13초 만에 텍스트 변환

구글의 멀티모달 임베딩 모델 '임베딩 젬마 2(EmbeddingGemma 2)'를 활용해 맥북 에어에서 1시간 분량의 오디오를 단 13초 만에 텍스트로 변환하는 새로운 음성-텍스트(STT) 앱이 공개되었습니다. 이 앱은 기기 내에서만 작동하며, 오디오가 외부로 유출될 걱정 없이 빠른 속도로 정확한 전사(transcription)를 제공합니다. 기존 STT 모델과 다른 접근 방식으로 효율성을 극대화한 점이 특징입니다.

8시간 전·2026.10.13·읽기 2분·amrrs

구글의 임베딩 젬마 2(EmbeddingGemma 2) 모델을 기반으로 한 새로운 음성-텍스트(STT) 변환 앱이 맥북 에어에서 1시간 분량의 오디오를 단 13초 만에 텍스트로 바꾸는 놀라운 성능을 선보였습니다. 이 앱은 완전히 기기 내에서(on-device) 작동하기 때문에 사용자 오디오 데이터가 외부 서버로 전송될 염려 없이 빠르고 안전하게 전사(transcription)를 수행합니다.

이 기술의 핵심은 임베딩 젬마 2가 원래 음성-텍스트 변환용으로 훈련되지 않은 멀티모달 임베딩 모델이라는 점입니다. 텍스트, 이미지, 오디오, 비디오를 하나의 공유 공간에 임베딩하는 이 모델의 특성을 활용하여, 오디오 인코더는 그대로 두고 '리더(reader)'라는 작은 모델만 추가 훈련했습니다. 이 리더는 짧은 오디오 조각을 모델의 텍스트 공간으로 옮겨 약 22만 9천 개의 영어 단어 중 가장 가까운 단어를 찾아 전사하며, 작은 추가 모델이 구두점과 대문자를 처리합니다. 이 리더 모델 훈련에는 8개의 H100 GPU로 2시간 미만이 소요되었으며, 현재 단어 오류율(WER)은 약 5%로, 선도적인 STT 모델의 2~3%보다는 높지만 향후 개선될 여지가 큽니다.

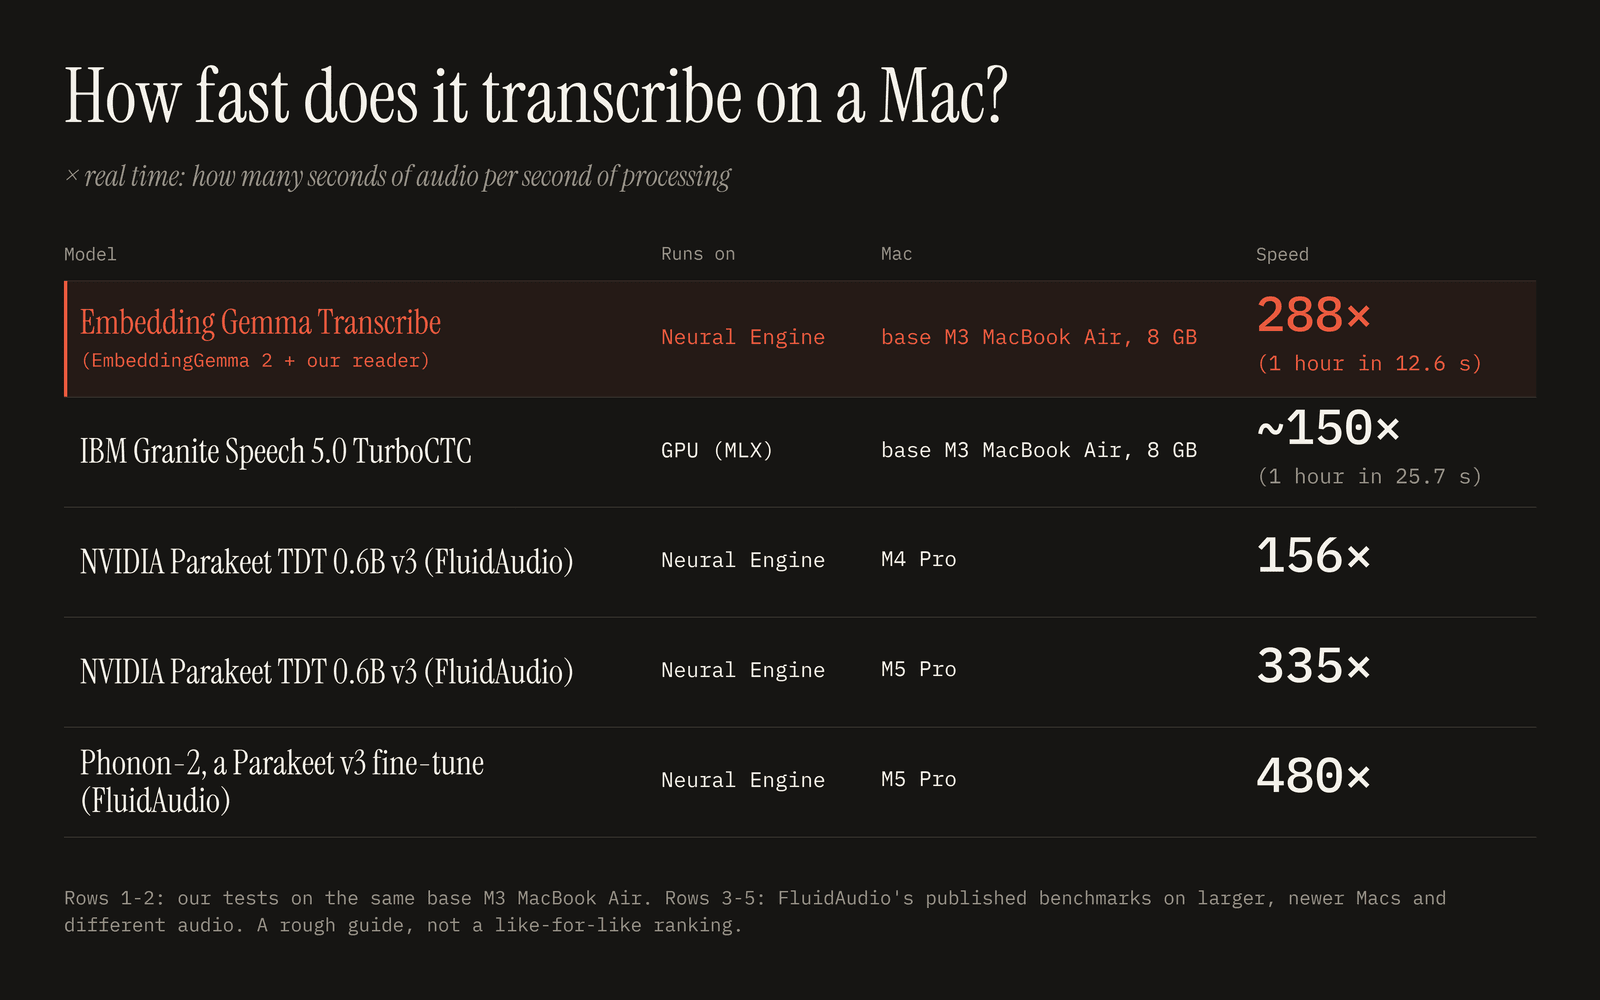
이 앱은 맥(Mac)의 뉴럴 엔진(Neural Engine)을 활용하여 M3 맥북 에어에서 1시간 오디오를 12.6초 만에 처리하는 등 뛰어난 속도를 보여줍니다. 이는 IBM 그라나이트 스피치(Granite Speech) 5.0 터보CTC 모델이 동일 기기에서 25.7초가 걸리는 것과 비교해 두 배 가까이 빠른 속도입니다. 사용자는 오디오 파일을 드래그앤드롭하거나, 옵션(Right Option) 키를 누른 채 말하여 어떤 앱에서든 받아쓰기(dictation) 기능을 활용할 수 있습니다. 이처럼 기기 내에서 고성능 STT를 구현함으로써 개인 정보 보호를 강화하고, 인터넷 연결 없이도 언제든 사용할 수 있는 유연성을 제공한다는 점에서 큰 의미가 있습니다.

1인 창업자를 위한 기회 분석
AI 분석 · 참고용이며 검증이 필요합니다
7/10
강한 신호
왜 7점인가

명확한 사용자 니즈(개인 정보 보호, 속도)와 1인 개발자가 기존 모델을 활용하여 틈새시장을 공략할 수 있는 가능성이 보입니다.

문제 / 미충족 수요

개인 정보 유출 우려 없이 빠르고 정확하게 음성을 텍스트로 변환하고 싶은 수요가 존재합니다.

한국 시장
국내 미진출 — 기회한국어 온디바이스 STT 솔루션은 아직 초기 단계이며, 특히 맥 환경에서는 경쟁이 적어 기회가 있습니다.
수익 모델

B2C 유료 앱 판매, B2B API 구독 · 돈 내는 주체: 개인 사용자(프리미엄 기능), 전문직 종사자(법률가, 의사 등), 기업(내부 회의록, 고객 상담 분석 등)

1인 실현 가능성
4/5

기존 모델을 활용하고 '리더' 부분만 훈련하는 방식이라 1인 개발도 가능하지만, 한국어 데이터셋 구축과 모델 최적화에 시간과 노력이 필요합니다.

진입 지점 (Wedge)

한국어에 특화된 온디바이스 초고속 음성-텍스트 변환 맥 앱을 개발하여 특정 전문 분야(예: 법률, 의료) 사용자에게 먼저 제공합니다.

이번 주 첫 실험

오픈소스 한국어 음성 데이터셋을 수집하고, 임베딩 젬마 2와 유사한 구조로 한국어 리더 모델을 훈련하는 PoC(개념 증명)를 시작합니다.

Original source
이 글은 Hacker News (Top)의 기사를 yozm.tech가 한국어로 재작성한 버전입니다.
원문 보기