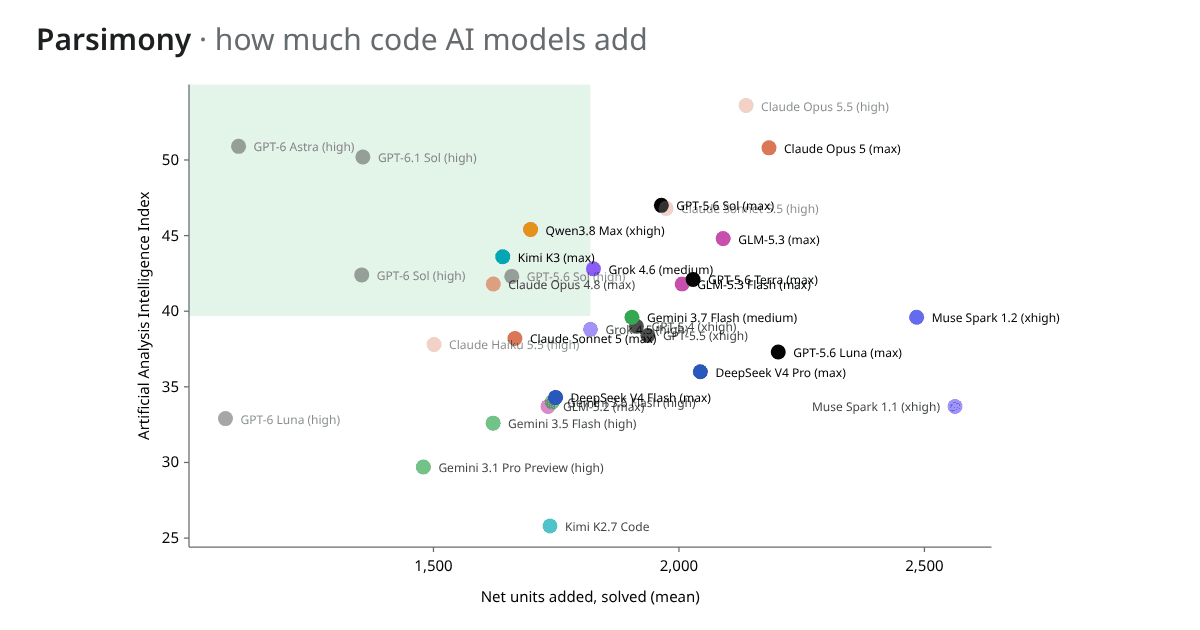
인공지능(AI) 모델이 생성하는 코드의 양을 측정하는 새로운 오픈소스 벤치마크 '파시모니(Parsimony)'가 공개되어 주목받고 있습니다. 기존의 AI 코드 생성 벤치마크들은 주로 문제 해결률이나 토큰 출력량, 비용 등에 초점을 맞췄지만, 파시모니는 AI가 불필요하게 많은 코드를 생성하는 경향을 지적하며, 이로 인해 코드베이스의 장기적인 유지보수가 어려워질 수 있다는 문제의식에서 출발했습니다.
파시모니는 '코딩 단위(coding units)'라는 독자적인 측정 방식을 사용합니다. 이는 구문 요소(statement), 함수 호출(call), 변수명(name), 리터럴(literal) 등 코드의 문법적 구성 요소를 세어 순수하게 추가되거나 제거된 코드의 양을 측정합니다. 단순히 코드 라인 수를 세는 방식이 아니므로, 불필요하게 한 줄에 많은 코드를 밀어 넣는 행위는 보상받지 않습니다. 또한, 삭제된 코드는 전체 측정에서 제외되어 순수하게 추가된 코드의 양을 파악하며, 파이썬(Python) 코드에 한정하여 측정됩니다. DeepSWE, SWE-bench Verified, SWE-bench Live 등 기존 벤치마크에서 공개된 패치(patch) 데이터를 활용하여 다양한 AI 모델의 코드 생성 간결성을 비교 분석할 수 있습니다.
이러한 측정 방식은 AI 모델이 생성하는 코드의 품질을 평가하는 새로운 관점을 제시합니다. 단순히 기능 구현 여부를 넘어, 실제 개발 환경에서 코드가 얼마나 효율적이고 관리하기 쉽게 작성되었는지를 가늠하는 중요한 지표가 될 수 있습니다. AI가 생성한 코드가 점점 더 실제 프로젝트에 통합되는 상황에서, 간결하고 유지보수하기 쉬운 코드를 생성하는 능력은 AI 모델의 실질적인 가치를 높이는 핵심 요소가 될 것입니다. 이는 장기적으로 개발자들이 AI 보조 도구를 선택하고 활용하는 데 있어 중요한 판단 기준이 될 것으로 예상됩니다.